📚 GPT-6、Astra 都不是 AGI 的终点
目录
——为什么通用智能必须先看懂世界、再学会说话:兼谈具身智能的真实战场
符号捷径造出的是一座悬空的塔:塔尖璀璨,地基尚是一片刚开挖的基坑。
引子:把三段视频放给 AI 看
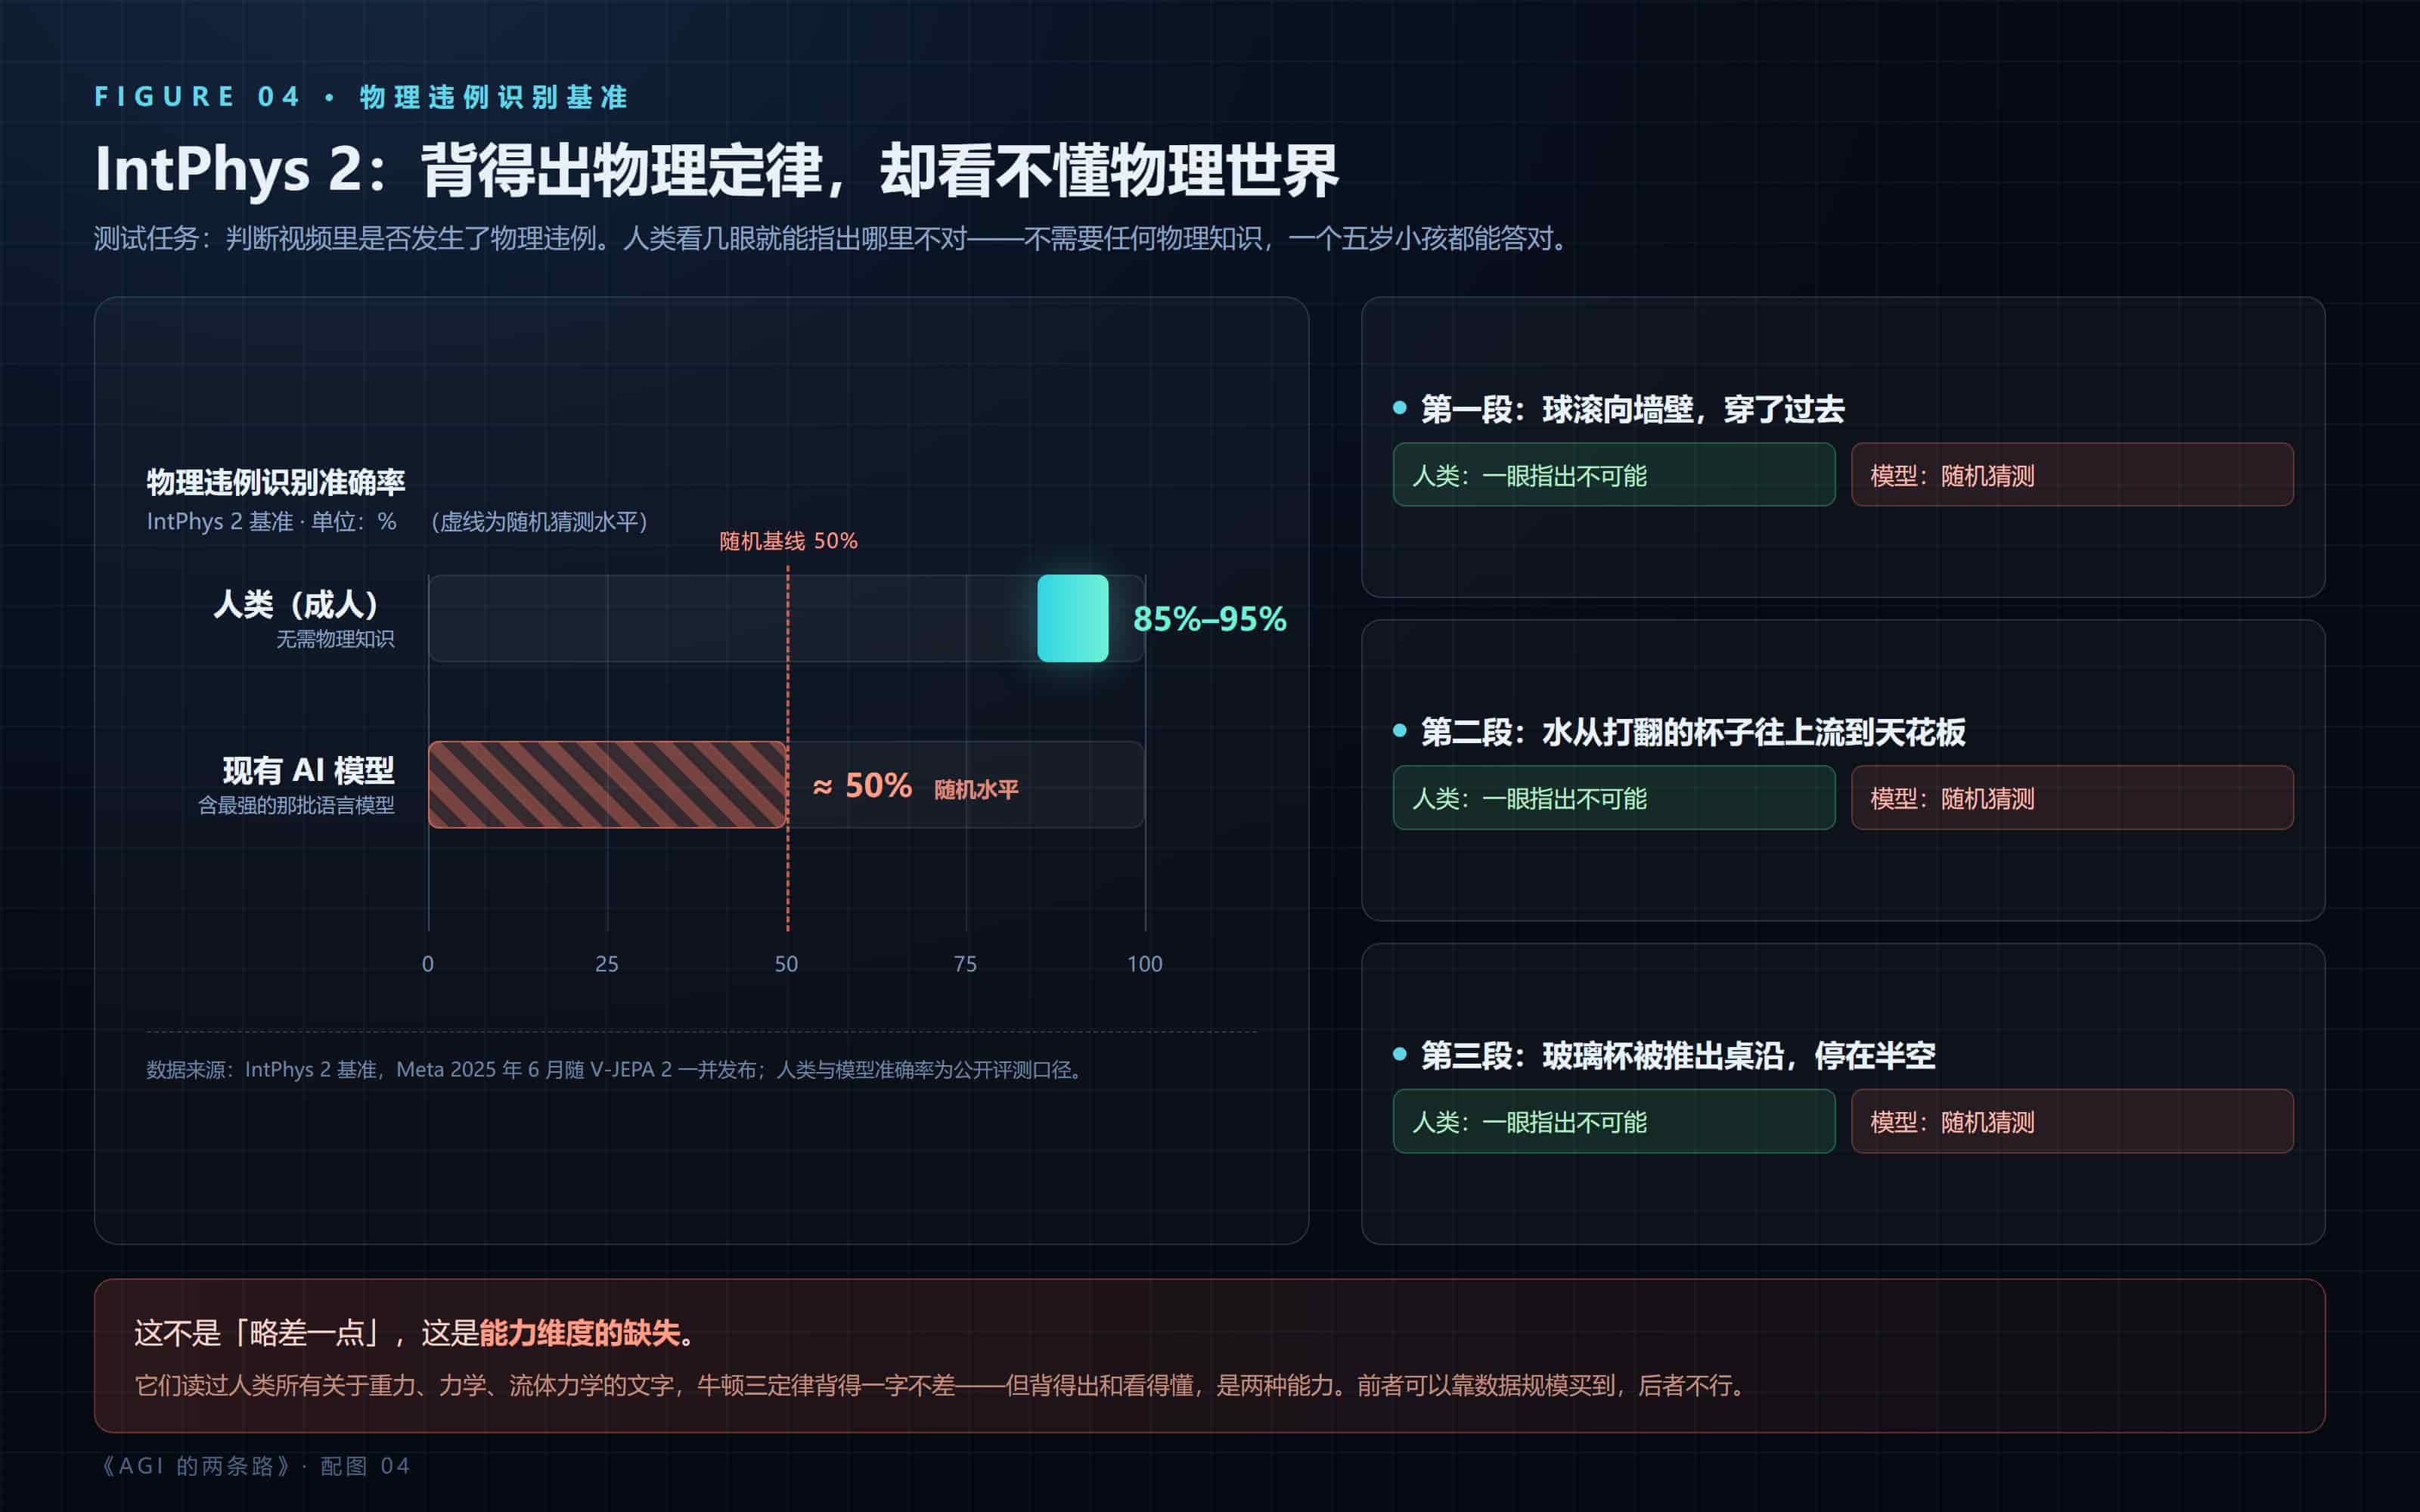
第一段:一个球滚向墙壁,穿了过去。 第二段:水从打翻的杯子里流出来,往上流到了天花板。 第三段:一只玻璃杯被推出桌沿,停在了半空中。
这三段视频是专门拍给机器看的测试题。人类看几眼就能指出哪里不对——不需要任何物理知识,一个五岁小孩都能答对。而把同样的题交给今天最强的 AI 模型——GPT-6、Astra,以及那些能写代码、能通过专业资格考试的模型——它们的准确率大致相当于抛硬币。
这就有点反常了。它们读过人类所有关于重力、力学、流体力学的文字,牛顿三定律背得一字不差。
但背得出和看得懂,是两种能力。
前者可以靠数据规模买到,后者不行。
这不是某个模型的 Bug,也不是调参能解决的问题。它来自一条技术路线在起点处做出的取舍——而这个取舍,决定了很多后来的事。
一、先把”智能”拆开,再谈模型
行业里争论 AGI 时,最常犯的错误是把智能当成一个标量——更高、更聪明、更接近人。但真实的人类智能不是一根刻度尺,而是两层完全不同的楼。
底下那一层:原生世界模型。
环境感知、视觉识别、躯体协调、物理因果直觉、时空预判、基础生存决策。这一层不需要语言,不需要符号,不识字也能有。所有高等动物、人类的婴幼儿,天生就带着它出厂。它的任务是解决”活着”这件事——看懂世界、预判变化、完成交互。
上面那一层:符号高阶智能。
抽象归纳、长链条推理、脱离现场思考、知识沉淀、跨时空处理、范式创新、知识传承。这一层是生物演化到很晚才涌现的,而且只挂在人类身上。它的载体是语言、数学、逻辑符号。
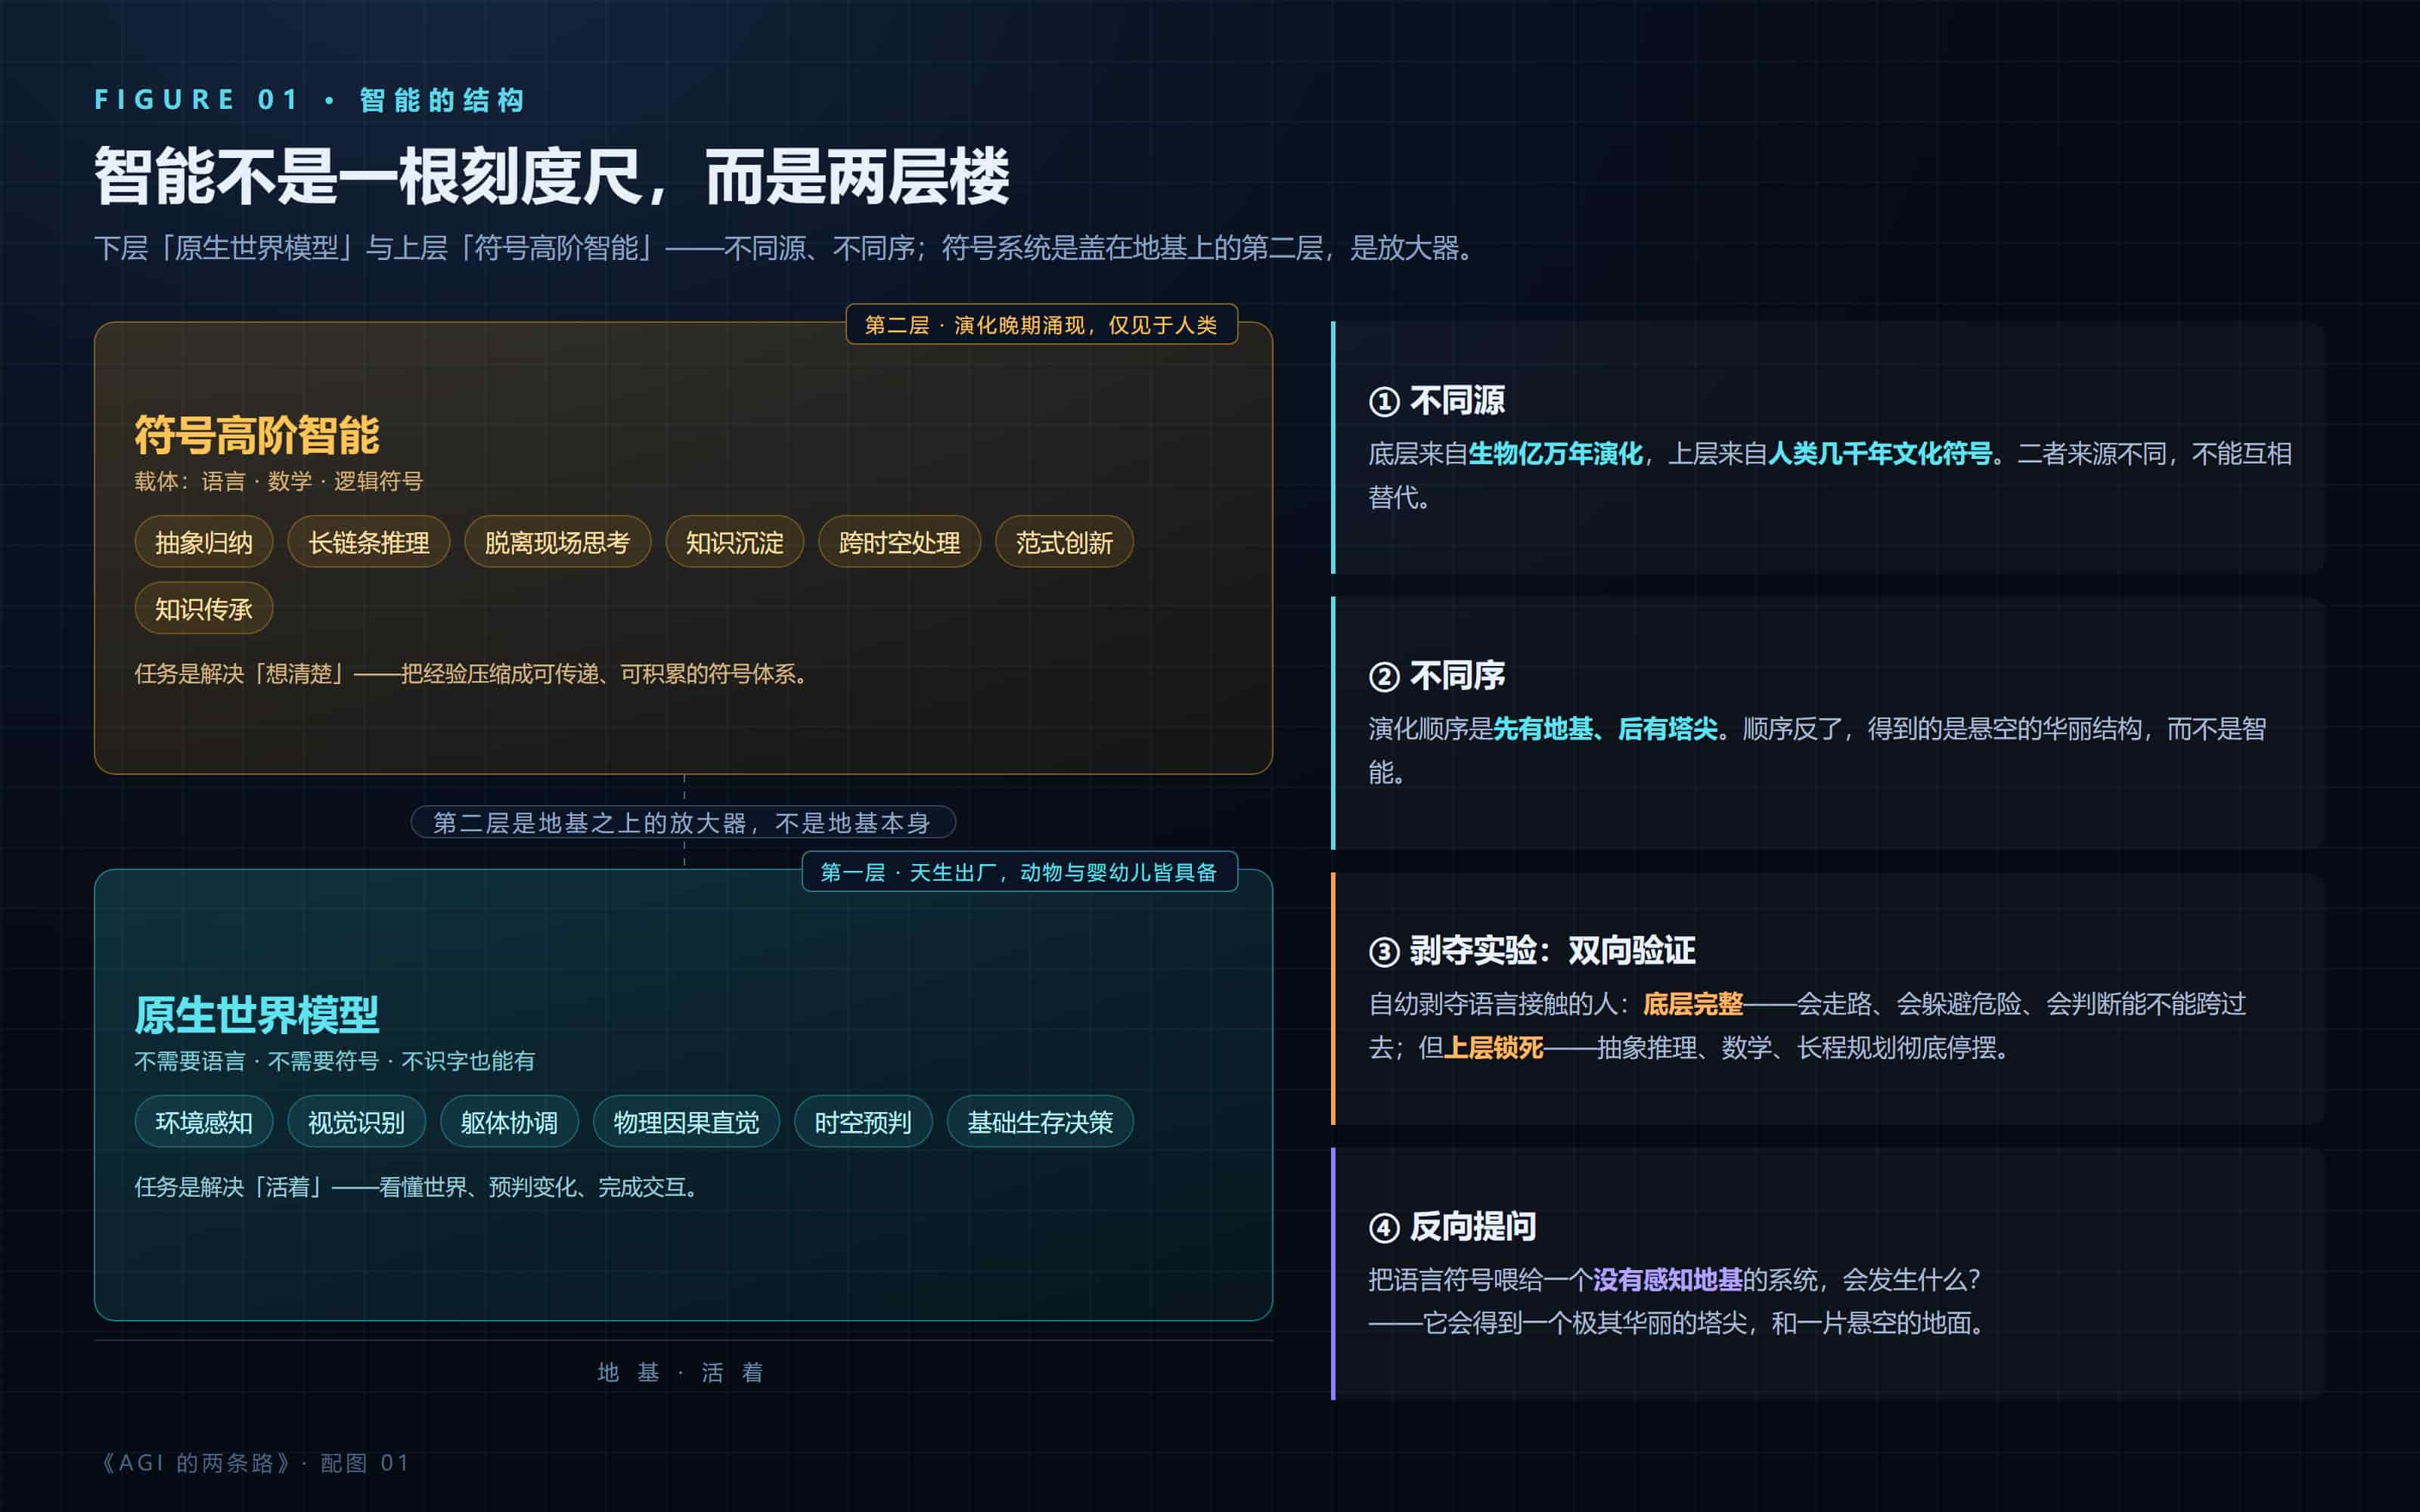
智能的两层楼——下层解决”活着”,上层解决”想清楚”;上层是放大器,不是地基。
关键的地方在于这两个东西不同源、不同序。符号系统不是智能的地基,它是盖在地基上的第二层,是一个放大器。
这个区分能立刻解释一个反直觉的现象:一个人如果自幼被剥夺语言接触,他的底层感知和生存智能是完整的——他会走路、会躲避危险、会判断能不能跨过去——但抽象推理、数学、长程规划这些能力会被彻底锁死。反过来,你把语言符号喂给一个没有感知地基的系统,会发生什么?
它会得到一个极其华丽的塔尖,和一片悬空的地面。
这正是今天大语言模型的处境。
二、两条路线,分歧不在技术细节
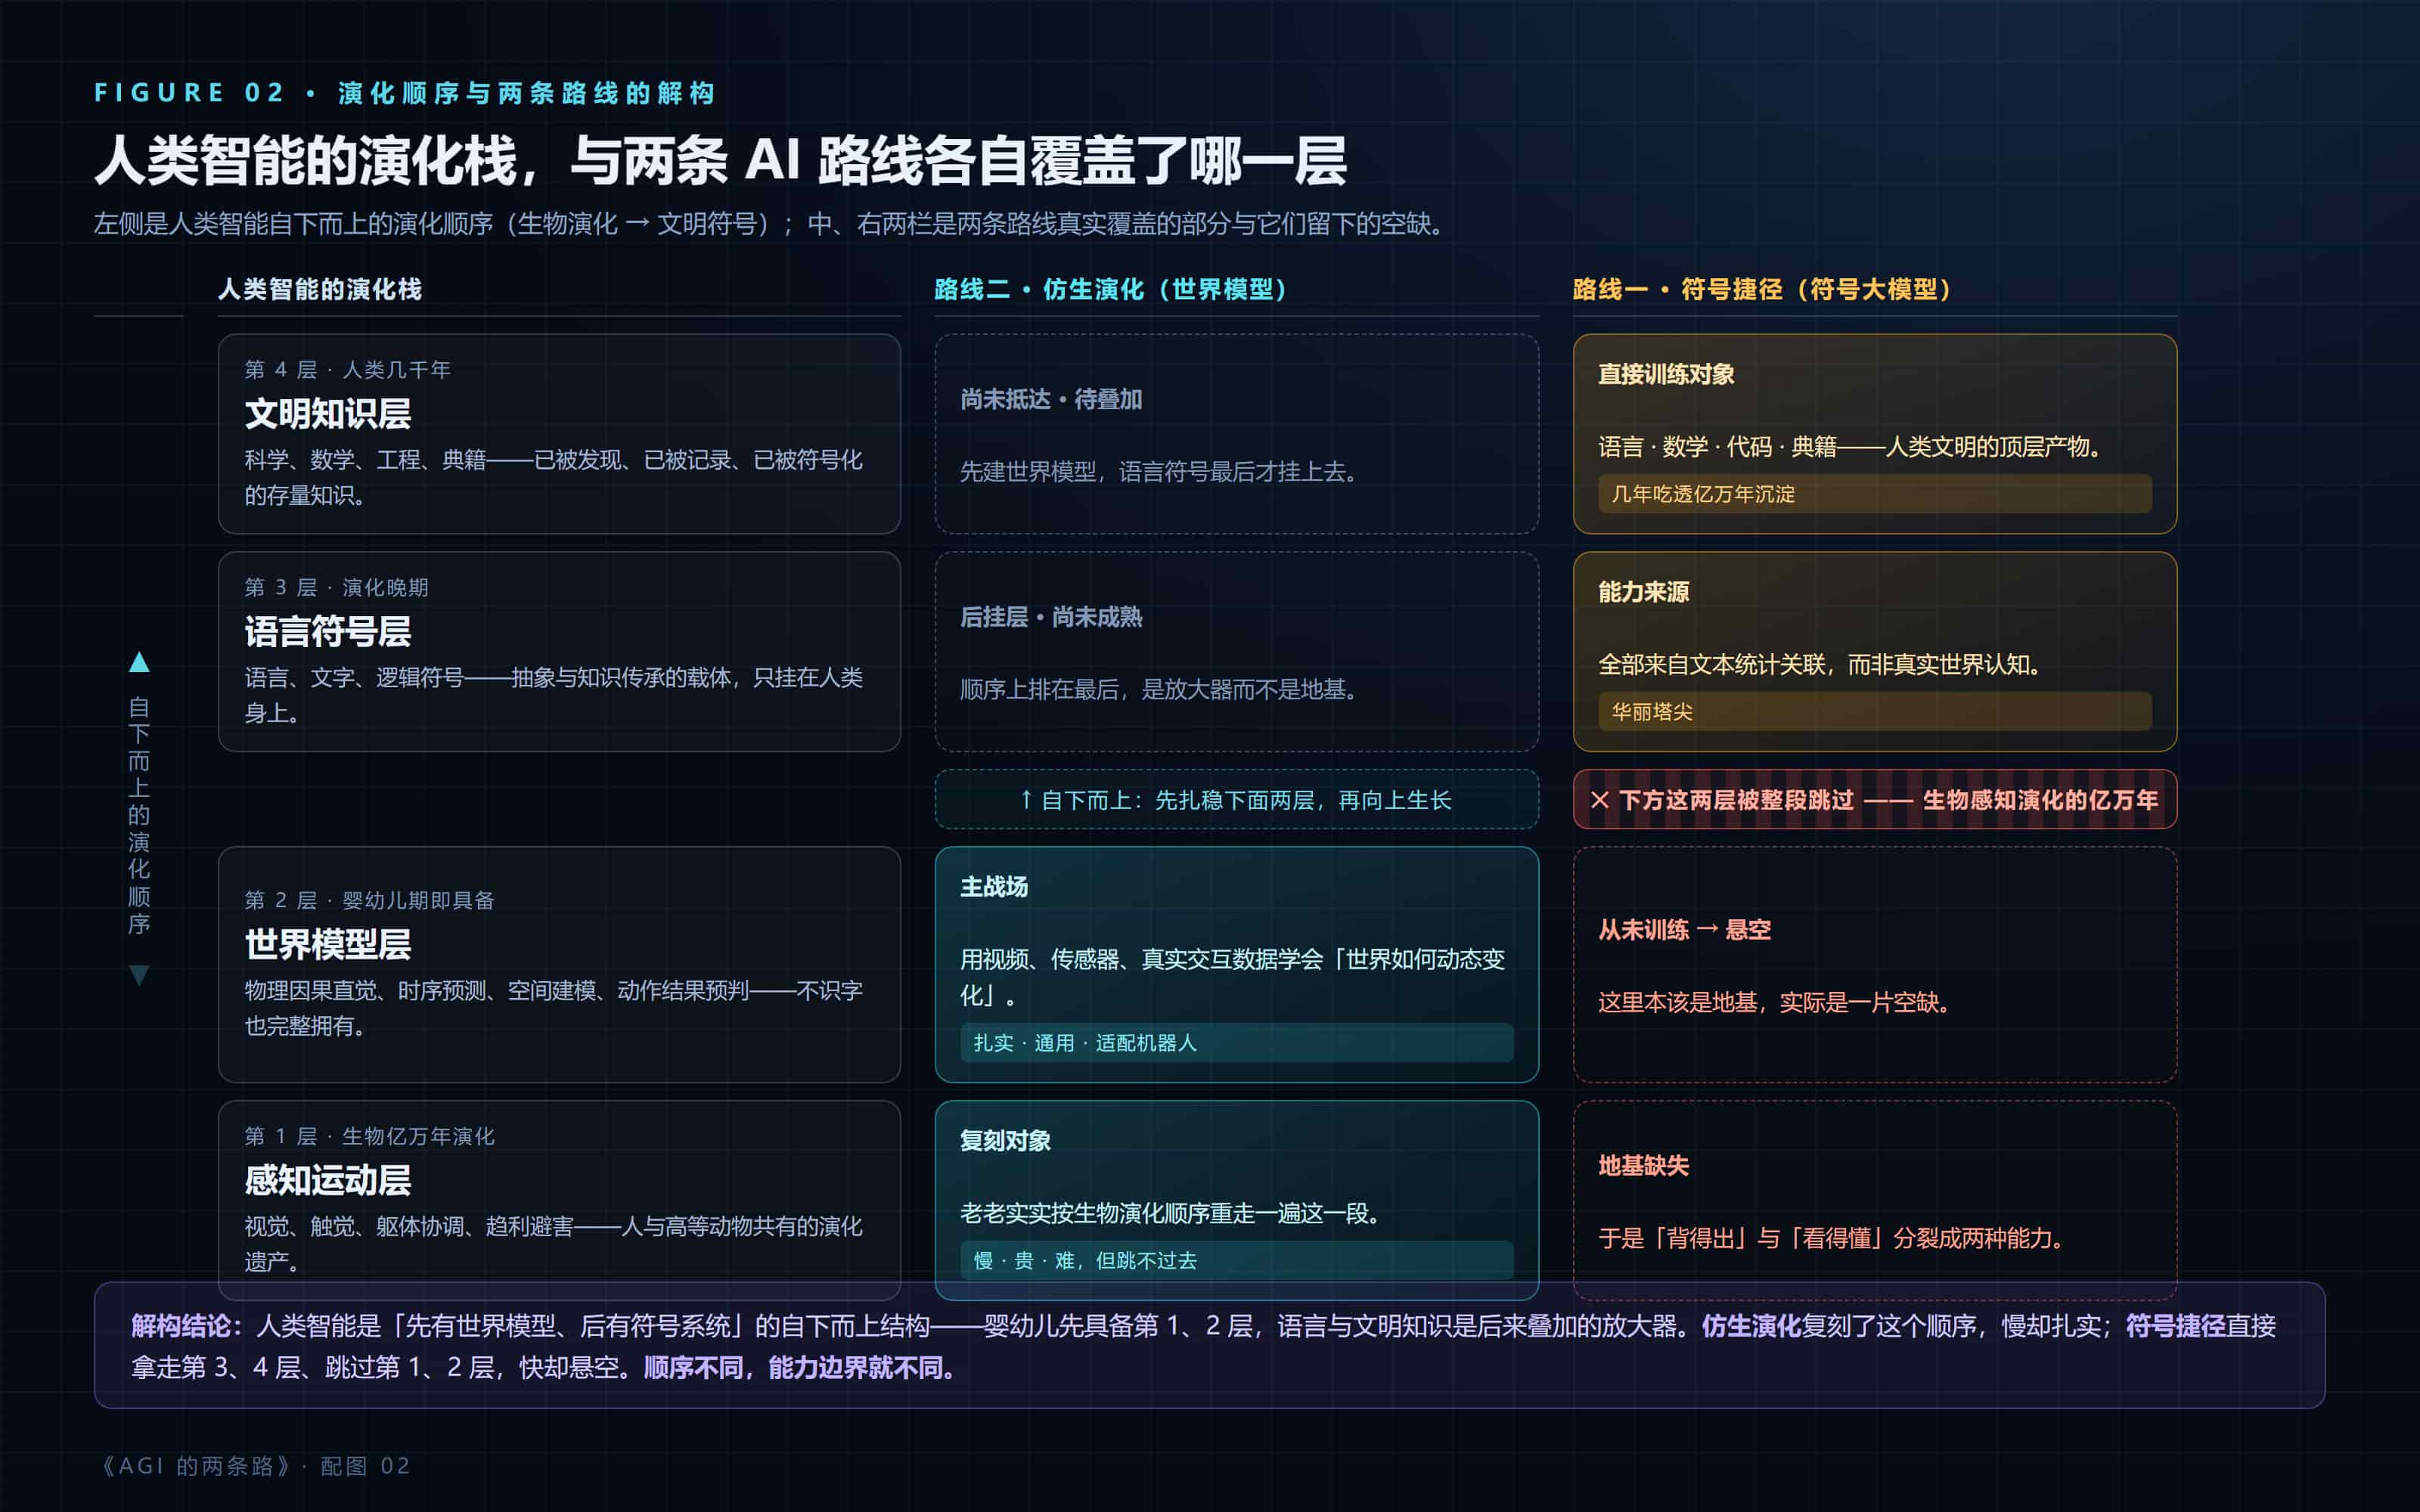
人类智能是自下而上长出来的;符号捷径直接拿走了上面两层,因此快但悬空。
AGI 探索到今天,全球其实只有两条真正的主干道。它们的分歧不在工程实现,而在一个更根本的问题上:智能应该从哪一层长起来。
路线一:符号捷径
代表是 OpenAI 系的大语言模型路线。
核心逻辑干脆利落:跳过生物感知那段漫长的演化,直接训练人类文明几千年的顶层产物——语言、数学、代码。模型不学真实世界,直接学人类已经把世界压缩成文字后的结果。
这条路的效率高得惊人。生物用了亿万年、人类用了几千年才沉淀下来的抽象知识和逻辑规律,它几年就吃了个遍。它天然适配人类的沟通方式、文字工作、逻辑处理、知识重组——商业化能力直接拉满。某种程度上,这是以最快的速度复刻人类现有文明成果的最优解。
但捷径之所以叫捷径,是因为它绕过了某些东西。
路线二:仿生演化
代表是 LeCun 多年来推动的世界模型路线,JEPA 架构是它的技术具象。
核心逻辑是老老实实按生物的演化顺序重走一遍:先用视频、传感器、真实交互数据,学会”世界如何动态变化”,建立物理因果和时序预测能力,再把语言符号挂上去。
它扎实,它通用,它天然适配机器人和真实场景。代价是工程难度极高、训练成本极大、迭代慢,短期几乎无法替代办公和知识类工作。
2026 年,这已经不是学术争论了
最直观的信号是钱和人的流向。
LeCun 在 2025 年 11 月离开了工作十年的 Meta,公开把”靠继续堆语言模型的规模通向超级智能”称作一条走不通的路。他随后创办 AMI Labs,据公开报道融资规模约 10 亿美元、估值 35 亿美元——赌的就是另一条路。
数字侧面也很能说明问题。Meta 2025 年 6 月开源的 V-JEPA 2 只有 12 亿参数,不到主流大语言模型的百分之一,却吃了超过 100 万小时的视频。它在从未见过的环境里做零样本抓取放置,成功率 65%–80%,而机器人演示数据的微调量只有 62 小时。
更扎心的是一个叫 IntPhys 2 的基准测试。它测的是模型能不能识别视频里的物理违例——物体瞬移、水往上流、球穿墙。人类在这个测试上是 85%–95% 的准确率,现有 AI 模型——包括最强的那批语言模型——大致在随机水平。
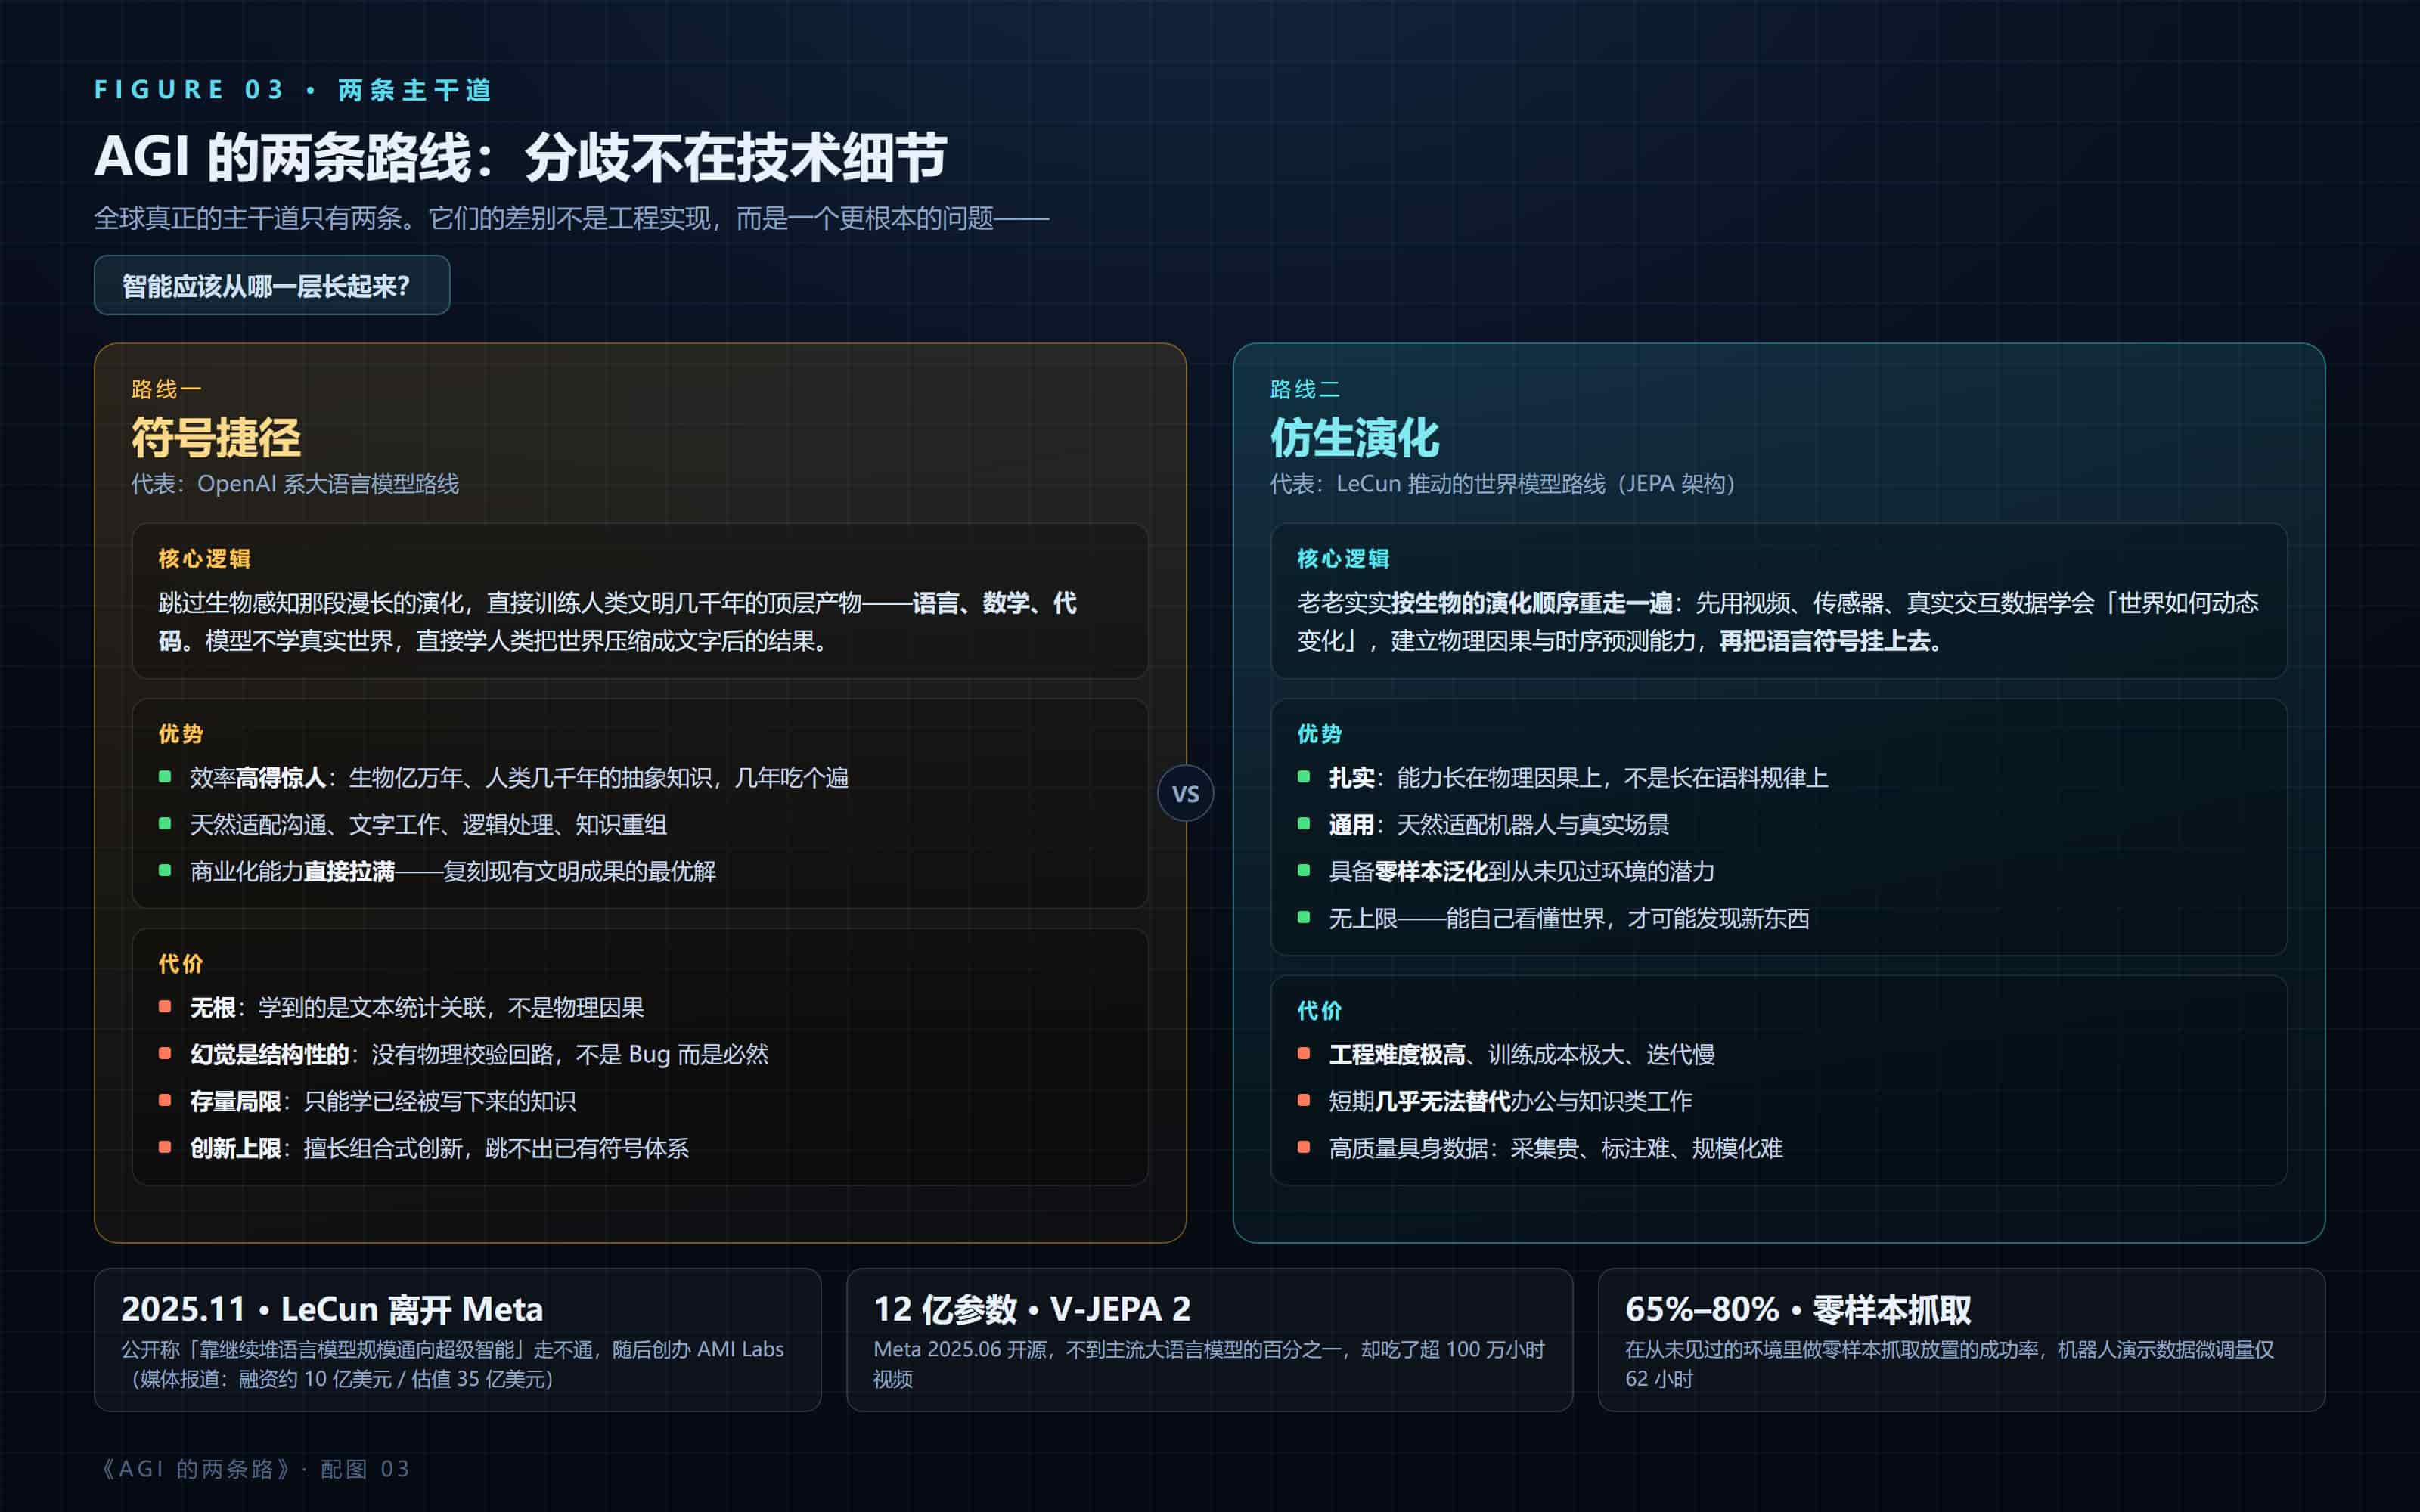
IntPhys 2:这不是”略差一点”,而是能力维度的缺失。
这不是”略差一点”,这是能力维度的缺失。
两条主干道的逻辑、优势与代价对照。
三、大模型的四个天花板,都不是能靠规模解决的
第一,无根。它所有的知识都是”文本统计关联”,不是真实世界认知。“玻璃”和”碎”这两个词经常一起出现,跟”推一下桌子上的玻璃杯它会掉下去摔碎”是两件完全不同的事。前者是语料规律,后者是物理因果。它学会了前者,并且能让它听起来像后者。
第二,幻觉是结构性的,不是缺陷。因为没有物理因果的校验回路,符号通顺和事实正确之间没有必然联系。在你熟悉的领域里,它能一本正经地胡说;在边界场景和未知场景里,出错是必然而非偶然。修 Bug 的思路救不了它,因为这不是 Bug。
第三,存量局限。它能学的只有人类已经发现、已经记录、已经符号化的知识。写完的、拍下的、发表过的,它都能消化;没被写下来的,它无从知晓——而人类知识的绝大部分,其实从来没有被写下来过。
第四,创新上限。它极其擅长组合式创新——把现有知识重新排列组合,做得比绝大多数人快得多也广得多。但范式级的、底层颠覆性的突破,需要的恰恰是”跳出已有符号体系”,而它整个存在方式就建立在已有符号体系之上。有研究团队把这件事写进了论文标题:语言模型跳不起来。
一句话概括:纯靠文本符号训练的大模型,无法超越人类现有文明的边界。 它能把已有知识整理、重组、优化到极致,但它不会替你发现新大陆。
四、为什么机器人不是大模型的战场
这一条值得单独说,因为它是当下最容易被带偏的判断。
具身智能的核心任务是:感知环境、识别物理属性、预判动作结果、实时闭环控制、适配非结构化场景。这些能力全部依赖视觉时序、物理因果、动力学预判、空间建模——也就是世界模型的地盘。
大模型的三个天生短板在这里暴露得最彻底:
它只有文本统计认知,没有物理先验。 它不懂真实的力学、摩擦、遮挡、形变,只会在语言层面”纸上推理”。
它是非实时的、非确定性的。 机器人底层控制是毫秒级的,推一次推理要等几百毫秒,物理上就没法闭环。
它无法预判动态扰动。 真实世界随时在变,它没有动态环境的预测模型。
2026 年 8 月的世界机器人大会上,这个瓶颈被讲得很直白。宇树王兴兴说,固定场景下经过充足专项训练,机器人任务成功率可以接近 100%,但只要换一件操作物品、环境稍微一变,成功率就大幅下降——“最后一厘米的偏差,导致成功率暴跌”。智源王仲远则用一只”天上飞的猪”形容视频生成模型的物理失效:视频模型能生成,物理世界不允许。
数据层面同样错位。大模型啃的是人类写好的二手经验,而世界模型要啃的是传感器和机械臂抓来的一手物理数据。人类高质量文本的存量已经接近见顶,但物理数据虽然每天都在海量新增,符合训练要求的高质量具身数据却极度稀缺——采集贵、标注难、规模化几乎无从下手。
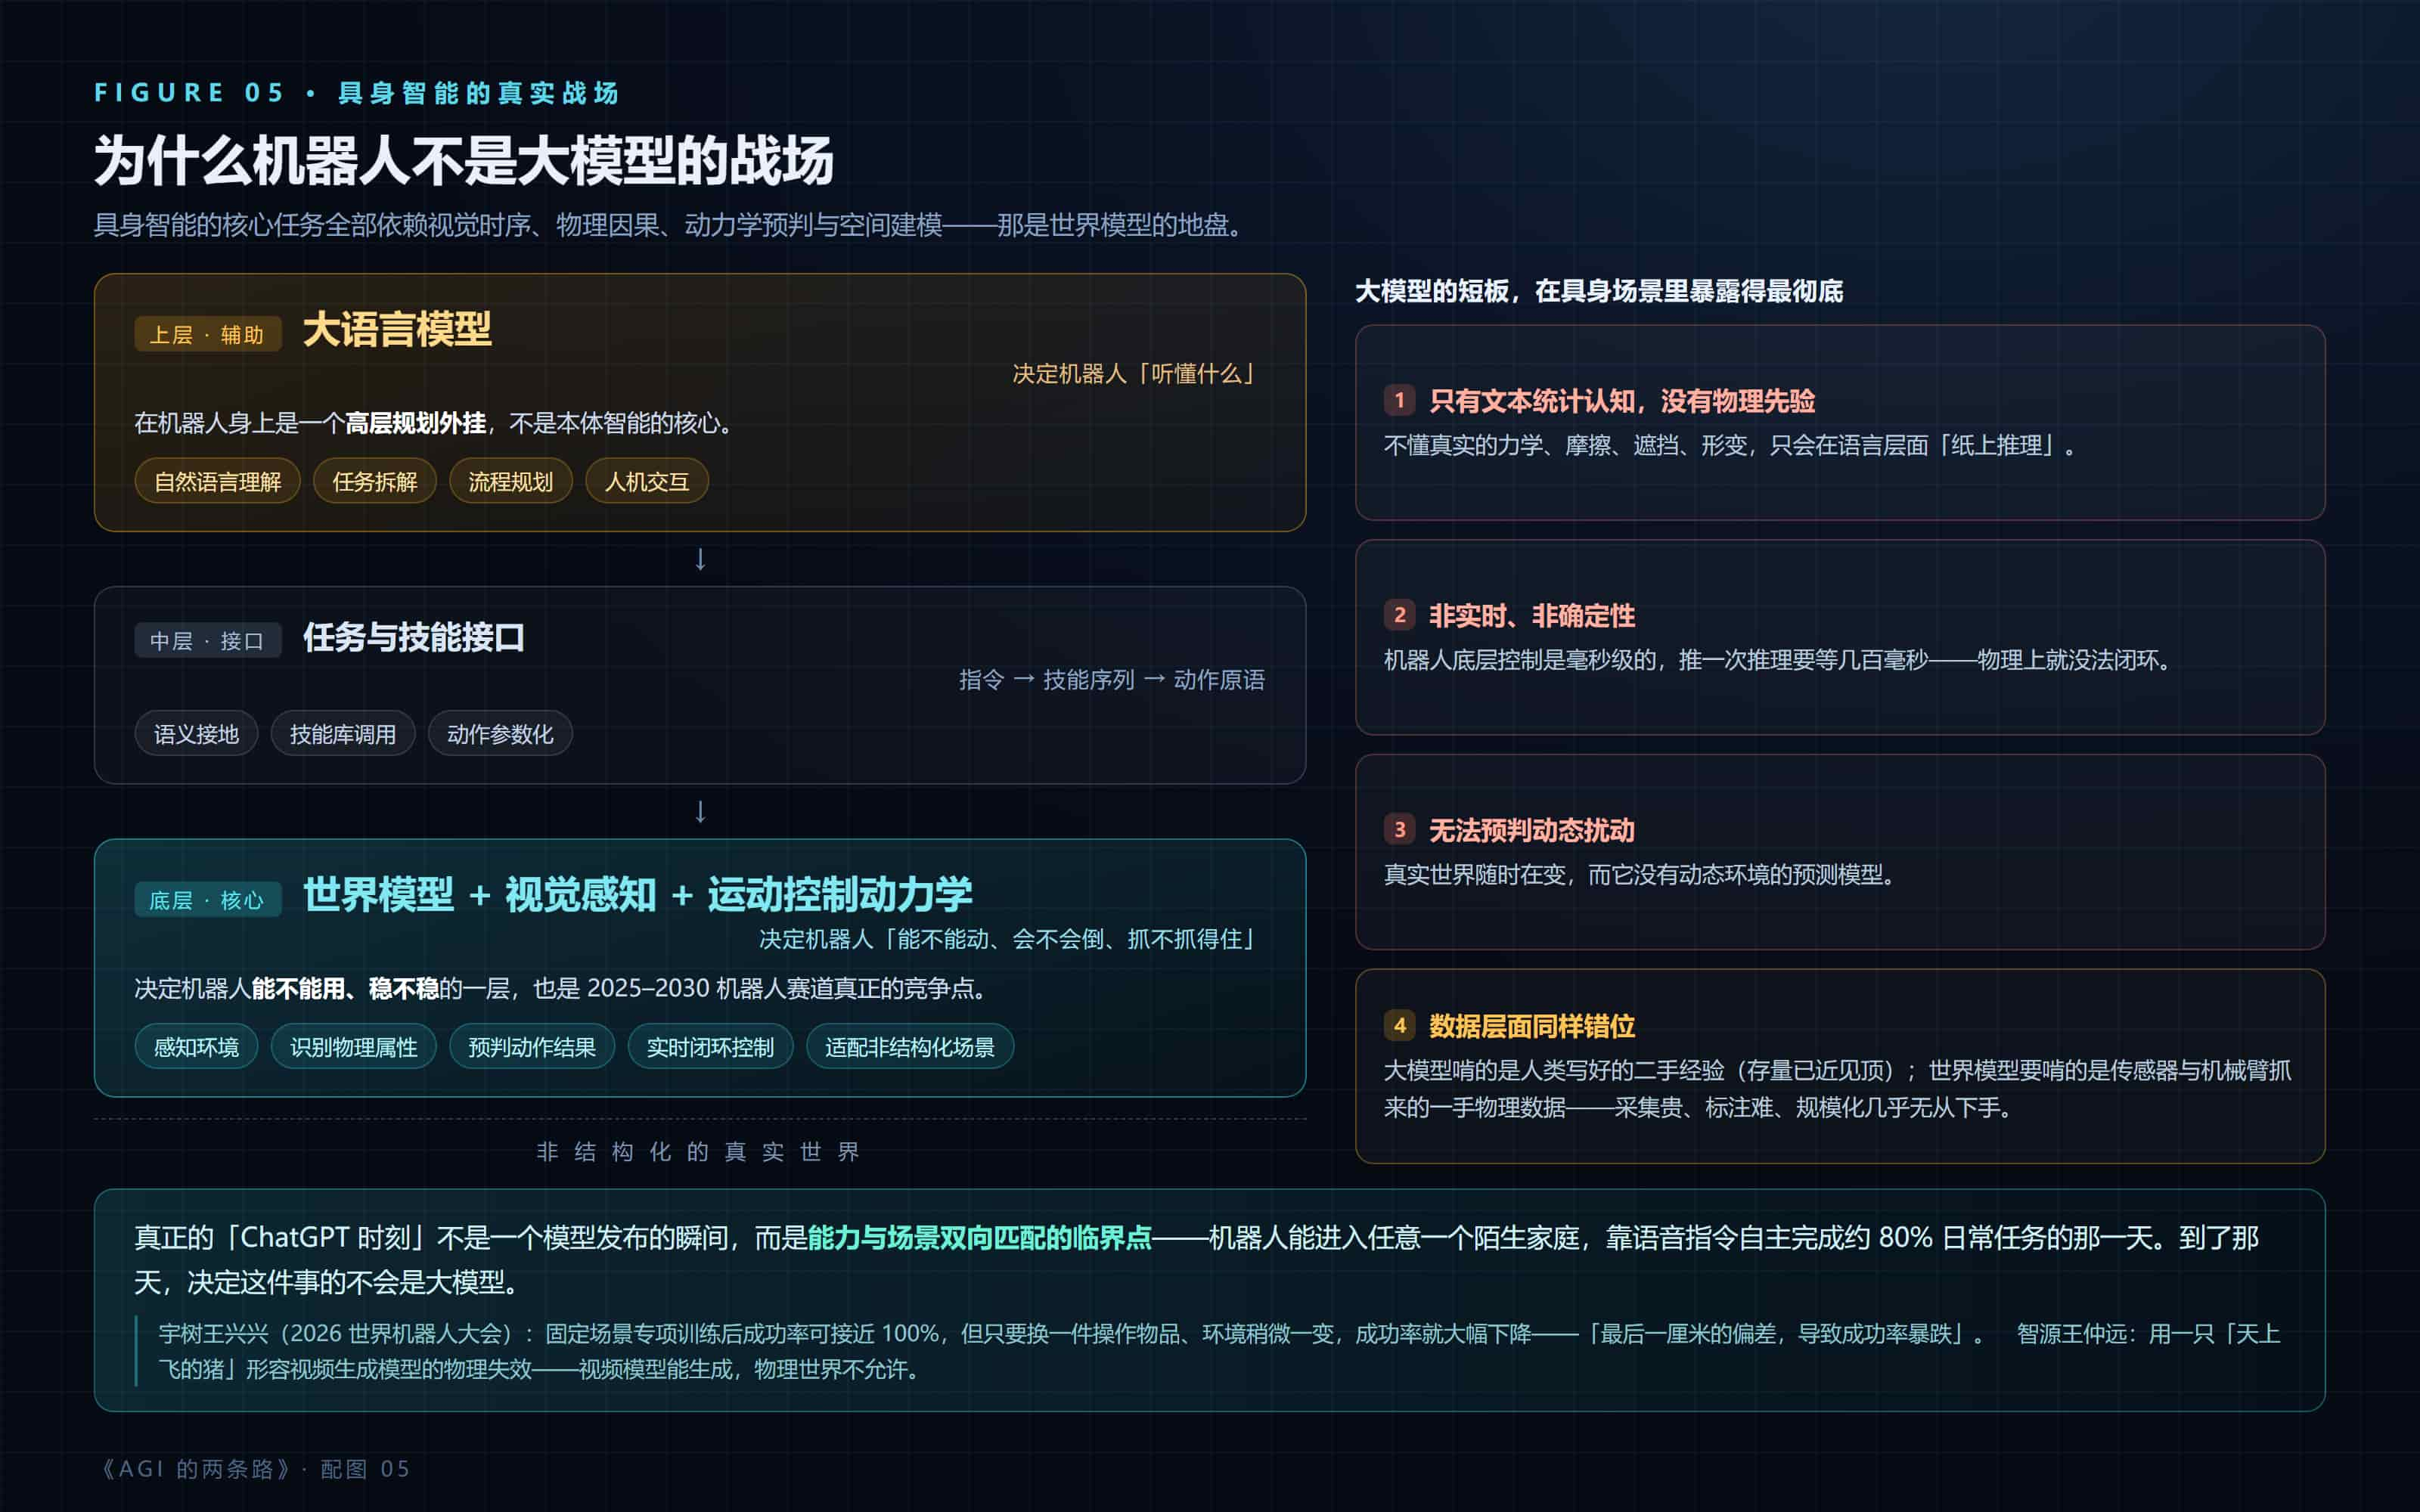
大模型决定机器人”听懂什么”,世界模型决定它”能不能动、会不会倒、抓不抓得住”。
所以现阶段两者的层级关系非常清楚:
- 底层核心,决定机器人能不能用、稳不稳:世界模型 + 视觉感知 + 运动控制动力学
- 上层辅助,决定机器人听得懂人话:大语言模型,负责自然语言理解、任务拆解、流程规划
大模型在机器人身上是个高层规划外挂,不是本体智能的核心。它决定机器人”听懂什么”,世界模型决定机器人”能不能动、会不会倒、抓不抓得住”。
短期的判断也由此而来:2025–2030 这个窗口,机器人赛道真正的竞争点是世界模型、具身感知和物理动力学智能,而不是谁的对话模型参数更大。真正的”ChatGPT 时刻”不是一个模型发布的瞬间,而是一个能力与场景双向匹配的临界点——按王兴兴的判据,是机器人能进入任意一个陌生家庭,靠语音指令自主完成 80% 左右日常任务的那一天。到了那天,决定这件事的不会是大模型。
五、终局是融合,但顺序不能反
把话说回到最根本的地方。两条路线没有绝对的对错,它们只是分别回答了不同的问题:
- 符号捷径回答的是”如何最快把人类已有的文明成果用起来”——高效,有上限。
- 仿生演化回答的是”如何造出一个能自己看懂世界、并发现新东西的智能”——扎实,通用,无上限,但慢。
通用文本 AI 靠大模型,通用具身 AI 靠世界模型。这两条赛道已经明确分化了。
而真正意义上的通用人工智能,大概率是两个都要:底层世界模型负责看懂世界、预判变化、真实交互、探索未知、压住幻觉;上层大模型负责抽象思考、逻辑推理、符号表达、知识沉淀、与人交互。 智源 2026 年 7 月发布的 RoboBrain Orca 走的就是这条路——先在统一的潜空间里学会”世界状态怎么变”,再按下游任务的需要,用不同解码器读出文本、图像或动作。它不是”更会聊天”的模型,也不是”更会生成视频”的模型,它想做的是那个更底下的东西。
这里我想留三个可以被打脸的判断,方便日后回头验证:
一、如果语言模型真的”跳过”了物理世界,那它在物理一致性测试上的表现应该会随规模自然提升。到目前,没有看到这个趋势。
二、如果底层的世界理解只能从物理数据里长出来,那么具身智能的进展速度,应该受限于高质量物理数据的供给速度,而不是模型参数量的增长速度。
三、如果终局是融合,那么融合的主导权应该由底层掌握。谁的世界模型更接近物理真实,谁就决定这套系统的上限;上层语言能力是可以被替换的,底层世界模型不能。
最后
对话式 AI 可以靠符号捷径迅速爆发,这已经发生了。但具身智能和机器人 AI 必须走生物演化的路径:先感知世界、理解物理、建立动态模型,再叠加语言符号。这不是风格选择,是一条跳不过去的技术规律。
回到开头那三段视频。真正让模型卡住的,不是”重力”这个词在语料里出现了多少次,而是一个物体被推下桌沿之后,那零点几秒里究竟发生了什么。
大模型已经拿到了人类文明最耀眼的塔尖。但塔尖下面那层地基——那个让所有动物活着、让一个婴儿学会伸手去够东西的东西——我们才刚刚开始动手挖。
谁能把这层地基补上,谁才真正握住了通向通用智能的钥匙。
附:本文主要事实来源
- LeCun 离职 Meta 及 AMI Labs 相关融资信息:公开报道(融资规模与估值均为媒体报道口径,非官方确认)
- V-JEPA 2 参数量、训练数据量、零样本操作成功率:Meta 2025 年 6 月发布信息及公开评测
- IntPhys 2 物理违例识别基准的人类/模型准确率对比:Meta 2025 年 6 月随 V-JEPA 2 一并发布
- 具身数据瓶颈、物理一致性时长、任务成功率衰减:2026 世界机器人大会(2026 年 8 月)公开报道
- 智源世界模型定义与 RoboBrain Orca:智源研究院 2026 年 6 月大会及 2026 年 7 月发布信息
本文为观点文章,基于既有技术思辨整理归纳,观点与推论部分属于作者判断,欢迎指正。